


合同会社Third Doorが、GPU不要・CPUだけで動作する日本語音声認識エンジンを開発したと発表しました。公開評価データでの比較では、OpenAIのWhisper large-v3やGoogle Speech-to-Textを上回る結果を示しており、音声認識の実用性を大きく押し上げる可能性があります。
目次Outline
Whisper large-v3やGoogle STTを上回る認識精度
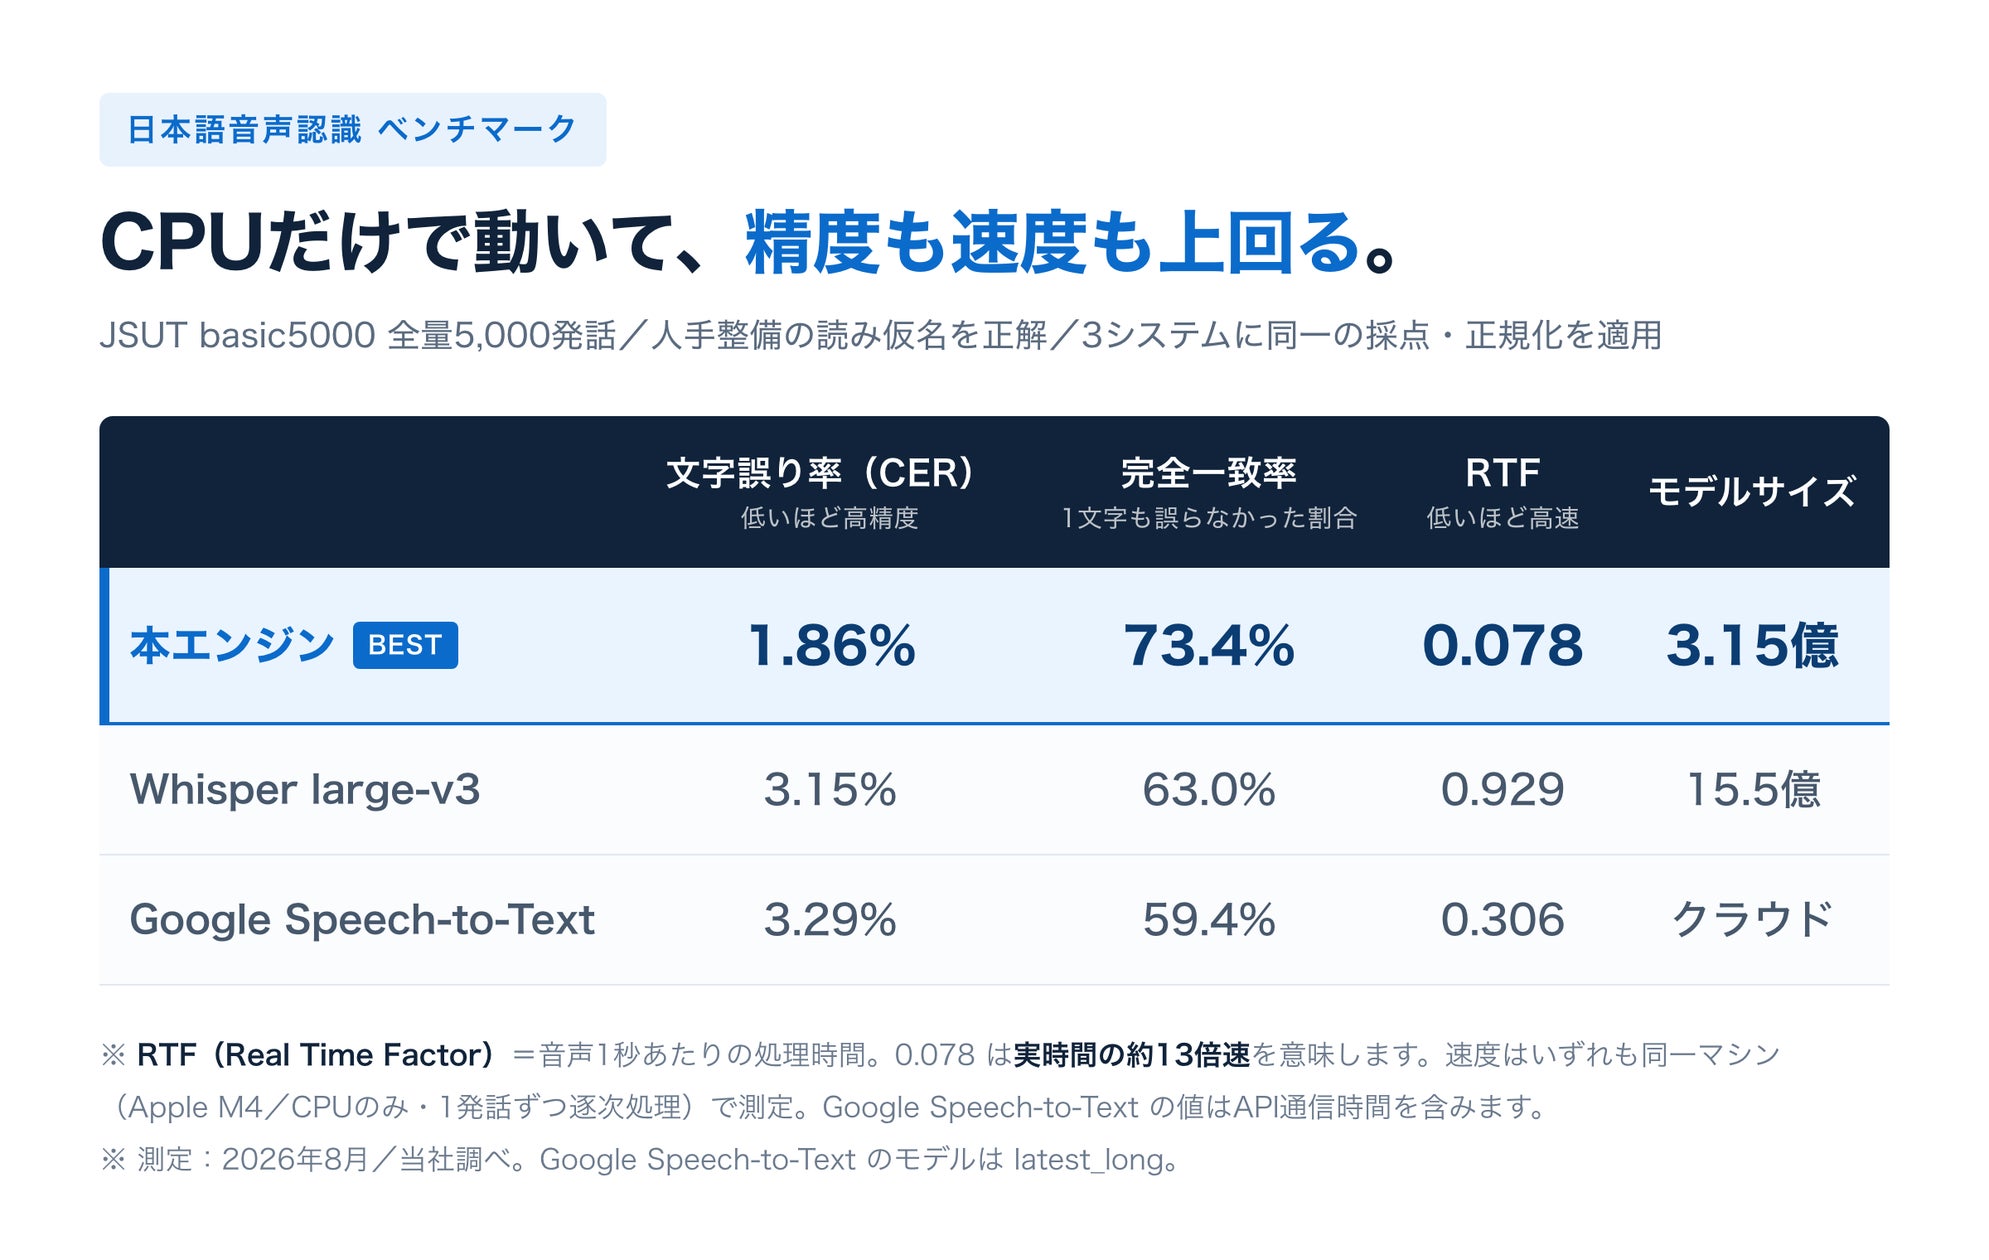
今回の発表で注目されるのは、評価データ「JSUT basic5000」の全量5,000発話を使った比較で、文字誤り率(CER)1.86%を記録した点です。これは、Whisper large-v3の3.15%、Google Speech-to-Textの3.29%を下回る数値で、精度面で優位性が示されました。
さらに、5,000発話のうち約3,700発話で完全一致を達成し、完全一致率は73.4%に達しています。比較対象より10ポイント以上高い結果となっており、実運用での信頼性の高さがうかがえます。
CPUのみで実時間の約13倍速を実現
音声認識は精度だけでなく、応答速度も重要です。Third Doorのエンジンは、Apple M4搭載ノートPCのCPU上で、実時間の約13倍速で処理できるとされています。つまり、会話のテンポを損ねにくく、音声対話システムに組み込みやすい設計です。
加えて、Whisper large-v3の約5分の1のモデルサイズでありながら精度で上回っている点も特徴です。GPUを前提にしないため、既存のPC資産を活用しやすく、導入コストを抑えやすいのも魅力です。
どんな場面で活用できるのか
- 電話応対の自動化や一次受付
- 会議・商談の議事録作成
- 音声データを外部送信できない環境での文字起こし
- オンプレミス運用が必要な業務
- 組込み機器やエッジ環境での音声UI
特に、クラウドAPIに音声を送れない現場や、回線ごとにGPUを用意しにくい構成では、CPUだけで動くことのメリットが大きくなります。セキュリティや運用自由度の面でも、導入しやすい選択肢になりそうです。
英語認識でもWhisper large-v3を上回る結果
この技術は日本語だけにとどまりません。英語音声認識でも同じ設計方針を適用し、公開評価データ「LibriSpeech test-clean」で単語誤り率(WER)1.91%を記録。CPU動作版でも2.24%となり、Whisper large-v3の2.47%を上回ったとしています。
日本語・英語の両方で成果を出している点からも、今後の多言語展開への期待が高まります。
ブラウザで試せるデモも公開中
Third Doorは、ブラウザ上で実際の認識精度と速度を試せるデモページも公開しています。最新版のChrome、Edge、Safariで利用でき、マイクの許可を与えるとその場で認識結果が表示されます。
音声認識は、実際に触ってみると精度やレスポンスの違いが体感しやすい分野です。今回のデモ公開により、企業側も導入イメージを持ちやすくなりそうです。
今後はAI電話応対システムへの組み込みを予定
同社は今後、この音声認識エンジンをAI電話応対システムに組み込み、音声対話サービスとして提供する方針です。英語版デモの公開や対応言語の拡充も進める予定で、活用範囲はさらに広がっていきそうです。
音声認識はAIの入口となる重要な技術です。今回のように、精度・速度・導入しやすさを同時に満たすエンジンが登場したことで、電話応対、議事録、オンプレミス文字起こしなど、実務でのAI活用は一段と進みそうです。
参考記事
この記事が気に入ったら
フォローをお願いします!
この記事を書いた人Wrote this article

sorein 教育×ITフリーランス / 女性
小〜高校教員として勤務し、製造業の社内SEを経験して教育×ITフリーランスになったsoreinです!教員免許や基本情報技術者、応用情報技術者、DBスペシャリストの資格を取得しています!ITニュースや技術書を読むのは趣味みたいになっています。
関連記事Related articles
